DATA PIPELINE 360
Automated Analytics Pipeline
DATA PIPELINE 360 est un projet de bout en bout qui montre comment transformer des fichiers sources bruts en un reporting Power BI structuré, fiable et exploitable.
Le projet couvre toute la chaîne : réception des fichiers, contrôle qualité, traitement Python, stockage SQLite, création de vues SQL, modélisation Power BI et visualisation des KPI.
Objectif du projet
Construire une chaîne analytique complète, automatisée et maintenable.
Contexte
Les entreprises reçoivent souvent plusieurs fichiers métiers dans des formats différents. Sans pipeline clair, les contrôles sont manuels, les erreurs se multiplient et le reporting manque de fiabilité.
Réponse apportée
Ce projet met en place un pipeline qui centralise les sources, contrôle leur qualité, crée des vues analytiques SQL et alimente un rapport Power BI multi-pages orienté pilotage.
Architecture du pipeline
Vue simplifiée des blocs techniques, de la réception des fichiers jusqu’au reporting final.
Dessin du flux : Sources → Python → Data Quality → SQLite / SQL Views → Power BI Model → Dashboard final.
Étapes détaillées
Le projet suit une logique séquentielle simple et robuste.
1. Réception des sources
- CSV Sales pour les transactions.
- Excel Master Data pour les dimensions produits, clients et magasins.
- CSV Targets pour les objectifs commerciaux.
2. Scripts Python
- Ingestion des fichiers.
- Contrôle de structure et de types.
- Détection des doublons.
- Gestion des erreurs et journalisation.
3. Stockage SQLite
- Tables fact et dimensions.
- Historique des fichiers traités.
- Base légère, simple à maintenir et portable.
4. Couche SQL
- vw_sales_daily
- vw_sales_monthly
- vw_product_performance
- vw_customer_performance
- vw_sales_vs_target
- vw_data_quality
- vw_sales_analysis
5. Modèle Power BI
- Relations entre tables.
- Mesures DAX centralisées.
- Filtres cohérents sur les visuels.
- Formatage des KPI et navigation utilisateur.
6. Restitution finale
- Tableaux de bord pour les ventes.
- Suivi des objectifs.
- Surveillance du pipeline.
- Documentation technique et KPI.
Défis techniques
Trois problèmes concrets traités pendant la construction du pipeline.
1. Fiabiliser les fichiers entrants
Problème : les fichiers peuvent contenir des colonnes manquantes, doublons, dates invalides, quantités négatives ou références inconnues.
Solution : mise en place de contrôles Python avant chargement : structure, valeurs nulles, doublons, types, cohérence des montants et clés de référence.
Résultat : les fichiers non conformes sont rejetés avant leur intégration dans la base et les anomalies sont tracées.
2. Éviter les doubles chargements
Problème : un même fichier ne doit pas être chargé plusieurs fois lors des exécutions successives du pipeline.
Solution : utilisation de la table File_History et des statuts SUCCESS / FAILED / ERROR pour suivre chaque traitement.
Résultat : les fichiers déjà chargés avec succès sont identifiés et le traitement devient traçable.
3. Préparer les données pour l’analyse
Problème : les données transactionnelles brutes ne sont pas directement adaptées au reporting et aux analyses récurrentes.
Solution : création d’un modèle SQLite avec tables de faits et dimensions, puis de vues SQL dédiées aux ventes, clients, produits, objectifs et à la Data Quality.
Résultat : Power BI consomme une couche analytique structurée et réutilisable.
Insights issus des données
Quelques résultats obtenus à partir des données de démonstration du projet.
Performance clients
Nadia El Amrani est le premier client du jeu de données avec 2 073,70 de ventes, devant Nord Distribution (899,00) et Atlas Services (769,30).
Performance produits
Laptop 15 Inch génère le chiffre de ventes le plus élevé avec 1 199,00, suivi de Wireless Headphones (1 029,70) et Smartphone (899,00).
Performance magasins
Rabat Agdal arrive en tête avec 2 073,70 de ventes, devant Casablanca Center (1 238,80) et Atlas Online (1 018,60).
Stack technique
Technologies utilisées dans le projet.
Pages du rapport
Chaque page couvre un angle de pilotage spécifique.
HOME
Page d’accueil du projet avec identité visuelle et navigation vers les différentes vues analytiques.
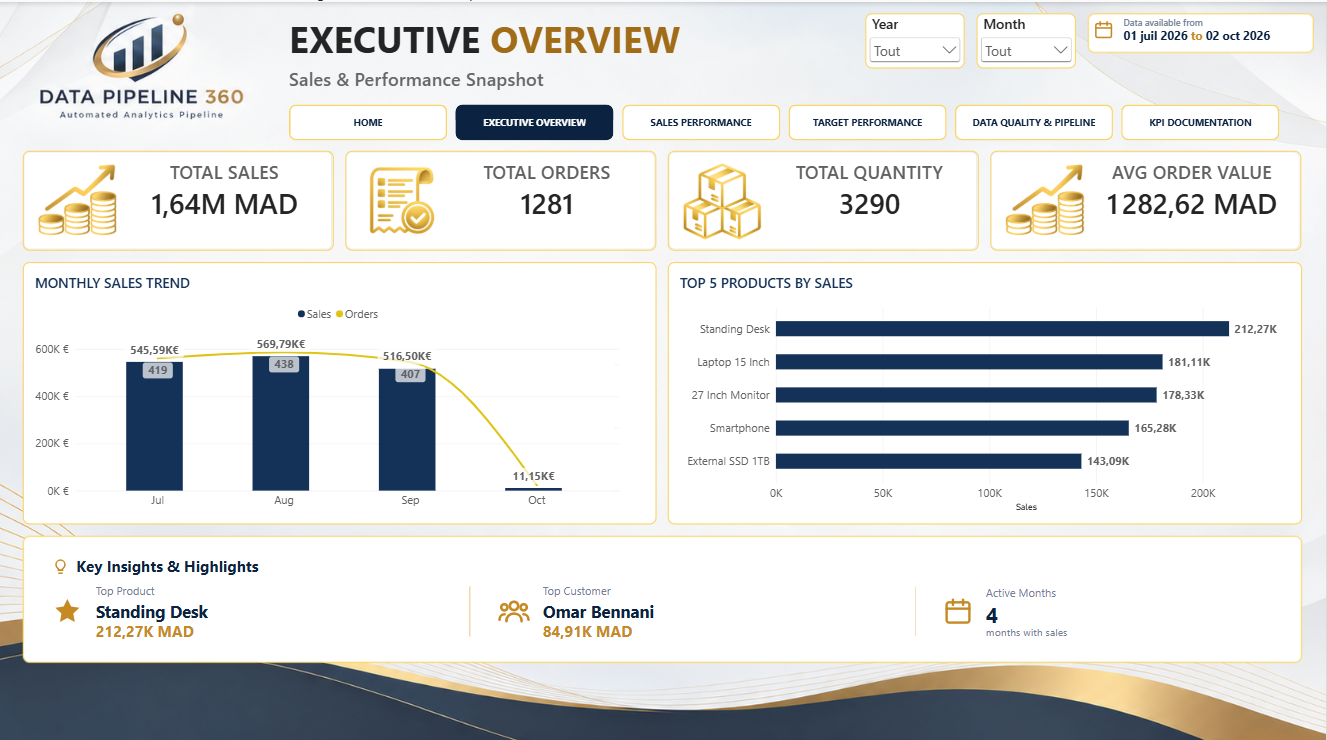
EXECUTIVE OVERVIEW
Vue synthétique des principaux KPI de ventes, tendances mensuelles, top produits et faits marquants.
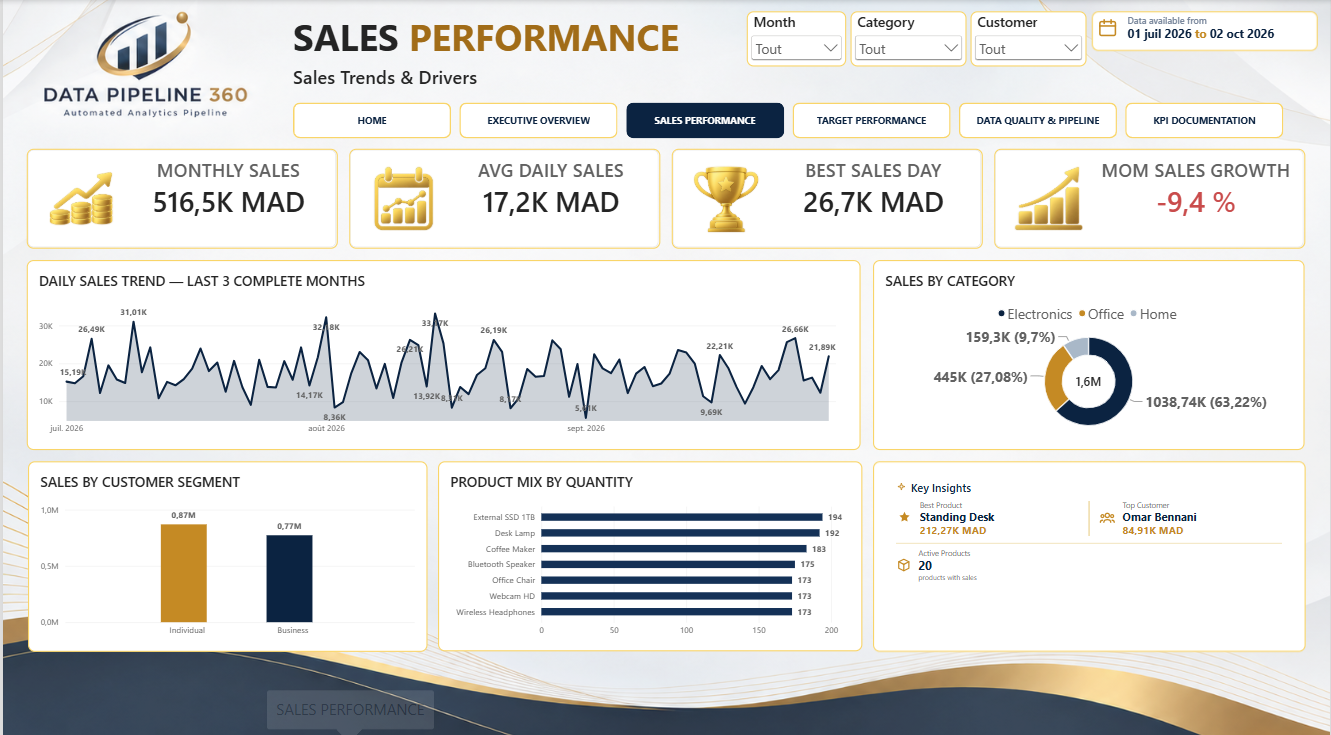
SALES PERFORMANCE
Analyse détaillée de la performance commerciale par période, catégorie, segment client et mix produits.
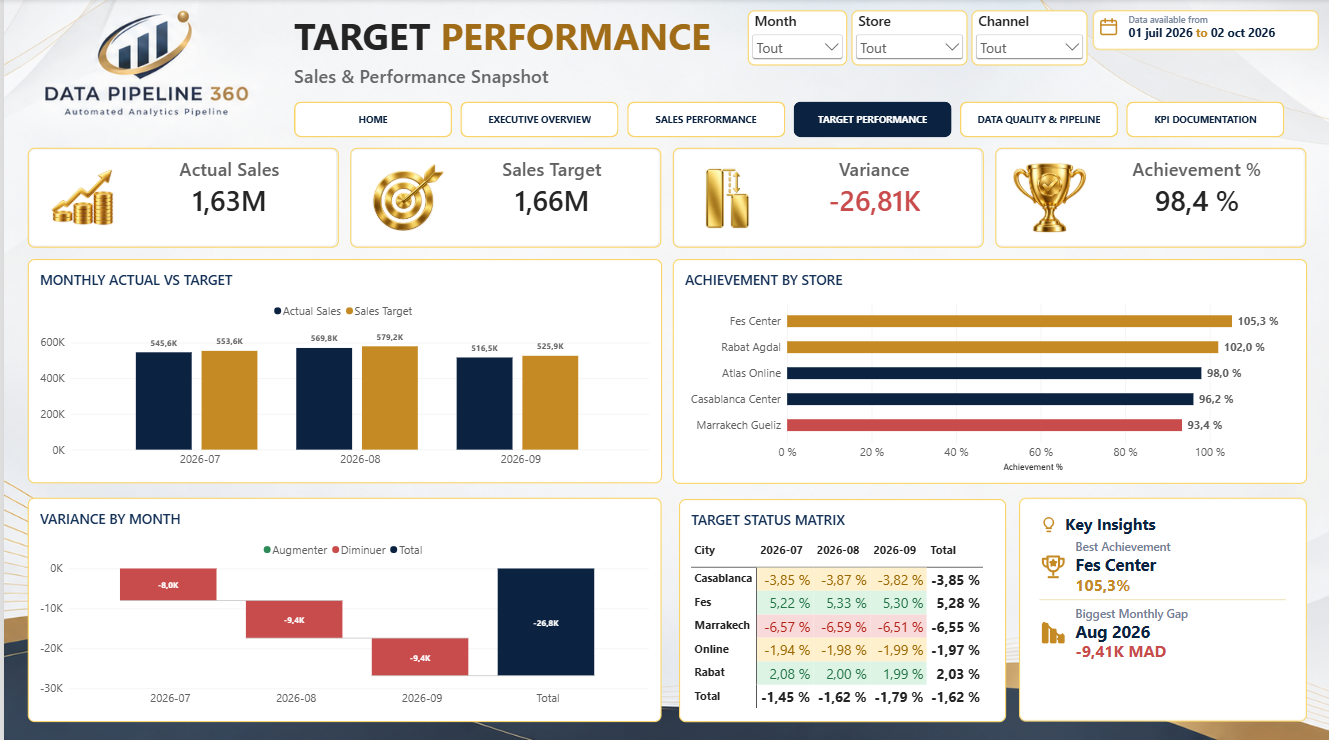
TARGET PERFORMANCE
Comparaison entre le réalisé et les objectifs avec focus sur l’achievement, les écarts et la performance par magasin.
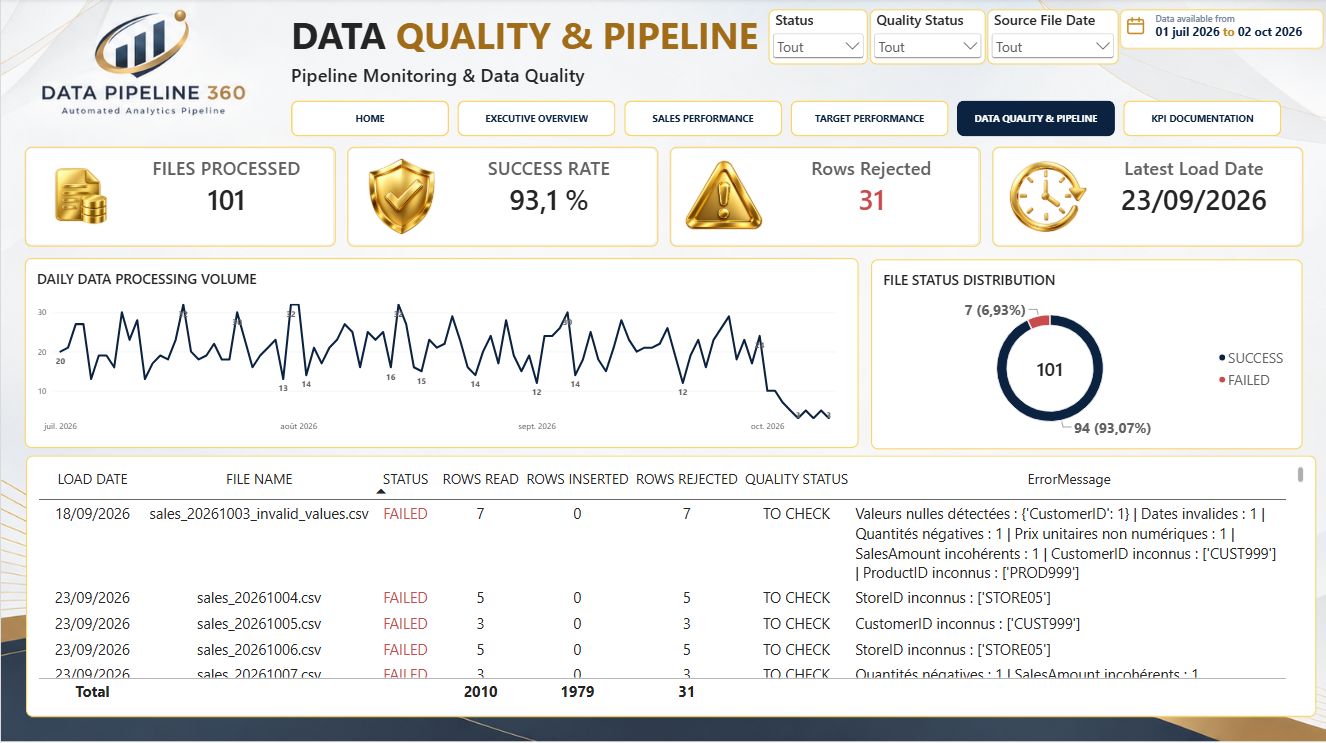
DATA QUALITY & PIPELINE
Suivi technique du pipeline : fichiers traités, taux de succès, lignes rejetées, activité de chargement et erreurs détectées.
Valeur apportée
Ce que ce projet démontre sur le plan technique et analytique.
Dimension technique
- Automatisation du flux de traitement.
- Contrôle qualité intégré.
- Séparation claire entre ingestion, stockage, transformation et restitution.
- Approche maintenable et évolutive.
Dimension métier
- Vision claire de la performance commerciale.
- Suivi des objectifs et des écarts.
- Pilotage de la qualité des données.
- Meilleure fiabilité pour la prise de décision.